A IA não esquece porque é burra. Ela esquece porque tudo que usa para responder precisa caber numa mesa de tamanho fixo. O texto vira ficha, a ficha sobe na mesa, e o que não cabe cai da ponta. Não tem aviso. Não tem mensagem de erro. A informação simplesmente deixa de existir para a próxima resposta.
É por isso que conversa longa degrada: você dá um dado, vinte mensagens depois precisa dar de novo, e ela responde como se fosse a primeira vez que ouviu aquilo. O lugar onde a conversa fica tem tamanho, e esse tamanho se mede em token, não em palavra e não em página.
Leve o mapa mental desta aula com você
O vídeo tem um apoio visual desenhado à mão, o mesmo que aparece na abertura e no fecho da aula. Está disponível pra download em Excalidraw, e abre arrastando o arquivo pra dentro do excalidraw.com, de graça, sem instalar nada.
O contexto, em três linhas
Sou engenheiro de software sênior e passei os últimos anos colocando modelos de linguagem em produção, em sistema que outras pessoas usam.
A pergunta que abre este texto é a que mais aparece quando a conversa com a IA fica longa. Quase sempre ela vem embrulhada em julgamento: a ferramenta é ruim, o modelo é fraco, ela não presta atenção. O mecanismo é outro, e ele também explica a conta que você paga.
Parece falta de atenção, e não é
A intuição errada é tratar o chat como uma conversa humana com memória. Você falou, então ela sabe. Na prática, cada resposta dela só enxerga o que está em cima da mesa naquele instante. Pergunta, histórico e arquivo dividem o mesmo espaço. Quando o espaço acaba, o que estava na ponta cai fora, e ela não escolhe o que cai.
Por isso o sintoma vem disfarçado. Não aparece um aviso de mesa cheia. A qualidade simplesmente piora: ela inventa um detalhe que você já tinha dado, ignora uma restrição do começo, ou pede de novo o que já estava no histórico. Parece falta de atenção. É falta de espaço.
Antes de subir, o texto vira ficha
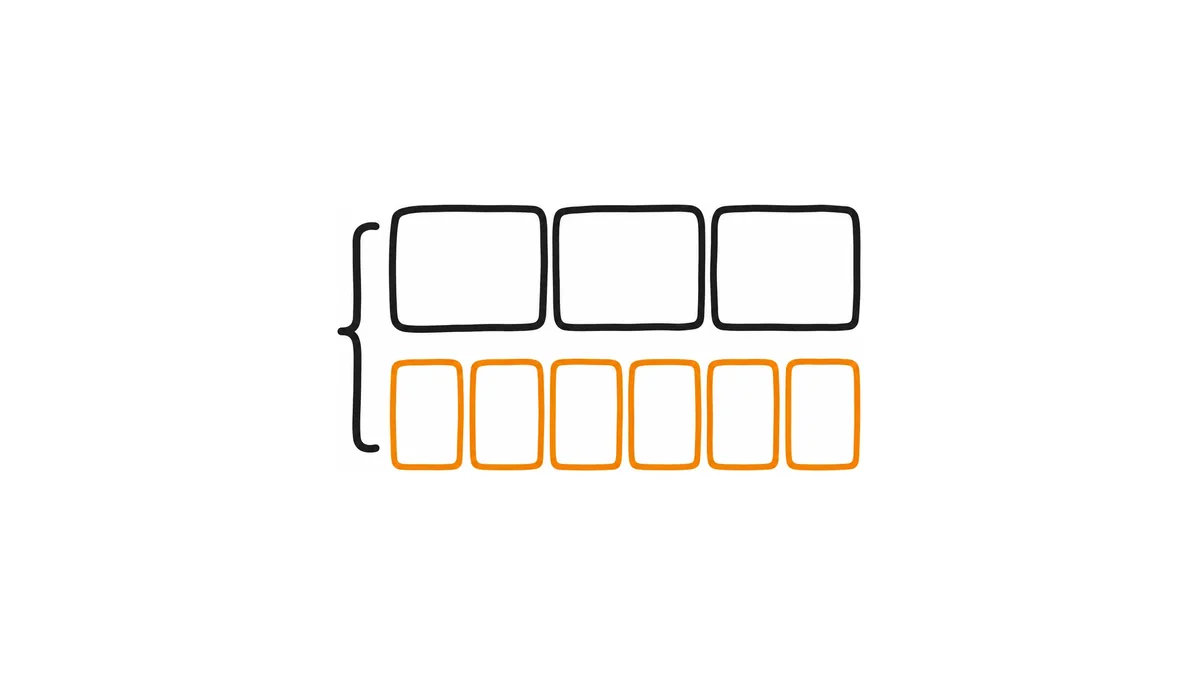
O que sobe na mesa não é o seu texto do jeito que você leu. Antes, ele é quebrado em pedacinhos. Cada pedacinho se chama token. Em português, ficha funciona melhor como analogia, porque é assim que a conta acontece: entra ficha, sai ficha, e o tamanho da mesa é o número de fichas que cabem nela.
Uma palavra curta e comum pode ser uma ficha só. Uma palavra longa, um acento ou um termo composto pode virar duas ou três. Não existe câmbio fixo entre palavra e token, e cada família de modelo quebra o texto de um jeito. Uma estimativa útil, cruzada em mais de uma fonte, é cerca de um token e meio por palavra no caso geral. Em inglês, cem tokens equivalem a cerca de setenta e cinco palavras. Em português a conta sobe, porque a tokenização foi otimizada para inglês: acento e palavra composta quebram em mais pedaços.
Essa diferença parece detalhe de engenharia. Não é. Ela explica duas coisas que o usuário sente no mesmo dia: conversa em português enche a mesa mais rápido, e o mesmo texto custa mais ficha do que o equivalente em inglês.
Tudo divide a mesma mesa
A mesa tem um nome técnico: janela de contexto. É o teto do que o modelo consegue considerar naquela resposta. Não é memória no sentido humano. É memória de trabalho: o que está visível agora, não o que já passou pela conversa em algum momento da sua vida.
Três tipos de coisa sobem nela ao mesmo tempo, e isso é o que a maior parte das pessoas não conta quando reclama do esquecimento. A sua pergunta. O histórico. Os arquivos que você colou. Em muitos sistemas entra ainda uma instrução de sistema, invisível, ocupando ficha antes de você escrever a primeira letra. Tudo isso é a mesma pilha. Não existe gaveta extra para o que “ela já deveria saber”.
Se não está em cima da mesa nesta resposta, para ela não existe. Não porque ela decidiu ignorar. Porque aquele pedaço já caiu, ou nunca subiu.
Mesa maior não resolve sozinha
A tentação, quando a mesa enche, é pedir uma mesa maior. Ajuda até um ponto. Depois disso, o problema muda de tamanho para aproveitamento.
Existe um efeito documentado em 2023, e confirmado desde então em mais de uma leitura técnica: o modelo presta muito mais atenção no começo e no fim do que está na janela, e perde o que está no meio. O nome que a pesquisa deu foi lost in the middle. A curva de desempenho parece um U. Informação crítica enterrada no centro de um contexto longo é a que mais some, mesmo quando tecnicamente ainda cabe.
É por isso que uma mesa grande e cheia de coisa irrelevante perde para uma mesa pequena e limpa. E é por isso que a qualidade da resposta já cai bem antes do limite estourar. Encher a janela não é o mesmo que usar a janela.
Você não controla o tamanho da mesa. Você controla o que sobe nela, e em que ponta isso senta.
A mesma ficha é o que você paga
O elo que quase ninguém conecta é este: a unidade do limite é a unidade da conta. Entra ficha, sai ficha, e as duas entram na cobrança. Texto comprido custa mais porque ocupa mais ficha. Português custa mais ainda pelo motivo de cima. Conversa gigante fica mais cara e pior ao mesmo tempo, porque você paga para manter na mesa um histórico que ela já não está usando bem.
Não precisa saber o preço de nenhuma plataforma para usar isso. O mecanismo já basta: cada parágrafo que sobe sem necessidade é espaço que alguma restrição importante pode perder, e é ficha que você pagou para ela olhar menos.
O critério: escolher o que sobe
Quatro regras, na ordem em que eu aplico.
- Suba só o que a próxima resposta precisa. Colar o trecho que importa rende mais do que mandar o documento inteiro. Histórico morto é ficha gasta.
- Conversa nova costuma render mais do que conversa arrastada. Quando o fio já encheu de desvio, recomeçar com um bloco curto e denso é limpar a mesa, não desistir.
- Peça um resumo antes de continuar, quando o histórico ficou longo. Você troca um monte de ficha ruidosa por um bloco que ainda cabe, e ainda está no começo da mesa, onde a atenção é maior.
- O que importa vai nas pontas. Restrição, formato e o dado que não pode cair ficam no começo e se repetem no fim. O meio é o lugar de onde a pesquisa mostra que a atenção foge.
A quarta é o aprofundamento que o vídeo só aponta: ela já diz que a atenção pesa no começo e no fim. O passo seguinte é escrever como se isso fosse verdadeiro, porque é.
Onde tudo isso fica registrado
Escrevo tudo o que aprendo aqui neste blog, que roda num plano de quatro anos da Hostinger, que eu recomendo.
O vídeo lá em cima é a aula sobre token e janela de contexto de um curso gratuito de fundamentos de inteligência artificial, com aulas curtas e um conceito por vez. O esquecimento que este texto explica é consequência direta do limite da mesa, e o curso segue pelo que ela faz quando o que precisa não está em cima dela.
O que eu faria diferente se começasse hoje
Eu pararia de empurrar conversa longa como se ela acumulasse inteligência. Eu escreveria o que não pode cair no começo e no fim, não no meio de um paste enorme. E eu trataria “ela esqueceu” como diagnóstico de mesa, não como julgamento de modelo.
No fundo esse nem é um assunto de chat. É o mesmo erro de raciocínio que a gente comete quando trata buffer de tamanho fixo como arquivo infinito, e depois culpa o sistema por ter deixado o começo cair. Fila que estoura, log que gira, cache que evicta: em todos eles a saída é a mesma, e é decidir o que merece ficar visível.
A newsletter sai todo domingo, com o bastidor do que eu estou construindo, incluindo o que não deu certo.
